

工程主题原型:#7 schema 演进型(最近 4 期 zheteng-012 #10 / 013 #1 / 014 #4 / 015 #9 → #7 首次使用,不重复 ✅)。本期钩子核心:配置的一次演进要从仓库传到内核,中间有四层,每层都能静默失败——而最贵的那一层不在日志里。
引子:备份成功了,然后它崩了
2026-10-28 17:48,部署机上这条命令的前两行是成功的。
$ bash scripts/config_sync.sh
💾 已备份: /opt/security-monitor/config.yaml.20261028_174820.bak
Traceback (most recent call last):
  File "/opt/security-monitor/src/config_migrator.py", line 54, in <module>
    import yaml
ModuleNotFoundError: No module named 'yaml'
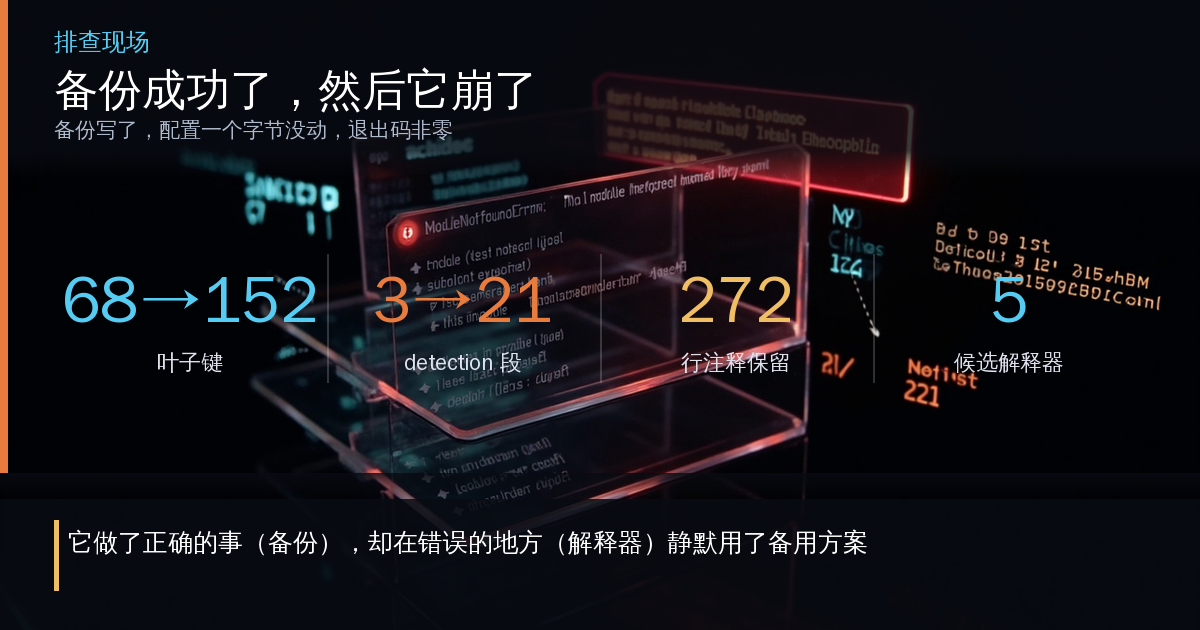
备份写了,配置文件一个字节没动,退出码非零。这是最难排查的一类失败:它已经做了正确的事(备份),却在错误的地方(解释器)静默用了备用方案。
而两天前的 10-26 16:18,这个仓库刚宣布过一次胜利:commit `6bb0609`,1955 passed,Phase 202 收尾,首次零失败。
同一时刻,10-28 凌晨 02:10 的部署机 diag 报告是这样开头的:33 项里 28 通过 5 失败,和 10-27 那份逐行相同,而仓库 HEAD 还停在 10-26 16:18 那次提交 —— 这已经是第 3 天同一集合。
所以三天的版图是这样:10-26 我们修完 9 个 diag bug 庆祝零失败,10-27 部署机报告同一组 5 项失败,10-28 还是同一组,中间代码一行没动。等 10-28 晚上真正动手,测试数从 1955 涨到 2131,而红的仍然是那 5 项。
这一期讲的就是这三天,以及一个 52 天前改偏的方向,怎么把整条封禁升级链路变成了摆设。
问题:四层传递,前三层的失败能看见,第四层不能
Phase 204 要解决的原始问题很简单,就一句运维抱怨:config.yaml 里内容有增有删,部署机 `git pull` 之后不会更新;手工替换成新版,白名单、路径、阈值又全丢。
第一层的答案反直觉:config.yaml 被 `.gitignore` 排除是设计,不是 bug。每台机器的配置本来就该各自保管,git pull 天然不动它。真正缺的是"新代码引入了新配置键,部署机怎么被告知并补全"这条迁移路径 —— 这也是我选 #7 schema 演进型的原因:这一期的骨架是一次 schema 演进,而不是一次单点 bug 修复。
于是补了 `scripts/config_sync.sh`:只补缺失键,已有键一个字不动,写前自动备份,默认 dry-run,`--apply` 才落盘,并挂进 update.sh 的 git pull 之后(阶段数 11 → 12,阶段自检同步改)。
第二层是迁移器本身。`config_migrator.py` 早就存在,问题在它的比对基准 `DEFAULT_CONFIG` 只有 68 个叶子键,而 `DetectionConfig` 实际有 16 个字段 —— `reputation_ban_threshold` 压根不在基准里,于是对稀疏 config 它报"0 缺失",永远看不见新键。
补完基准(68 → 152 个叶子键,17 个顶层段,detection 段从 3 涨到 21)之后,立刻露出三个更脏的 bug。
一是 `_deep_diff` 的 change 字典里,`path` 存的是当前层相对 key,`key` 才是全路径,而 `_apply_changes` 用 path 建嵌套 —— 于是 `monitoring.ssh` 被写成顶层 `ssh:`,`detection.sensitive_paths` 被提到顶层,而且不收敛:写错层之后 diff 又找不到,永远差 5 个键。
二是 `attack_chain.phase_map` 的键是整数 0..3,用点分字符串写回变成 `"0"`,按 int 查永远是 4 个缺失。
三是 `_find_key_line` 按缩进全文扫,`monitoring.web.enabled` 会被 `detection.ml_anomaly_detection.enabled` 这个同名兄弟劫持,保留注释的写入路径静默退回全量重写 —— 实测 config.yaml.example 一次丢 272 行注释。
第三层是"迁移脚本到部署机"这一段,也就是开头那个 `ModuleNotFoundError`。
第四层是迁移的下游:配置下发了,应用层有没有按它执行;应用层执行了,内核有没有真的收到。
四层里,前三层失败都能在日志里看见,第四层看不见。而这一轮最贵的错,全在第四层。
排查:签名会撒谎
`ModuleNotFoundError` 的根因不在 migrator 里。原脚本这么找解释器:`PYTHON_BIN="${PYTHON_BIN:-$PROJECT_DIR/.venv/bin/python3}"`,下一行是 `[[ -x "$PYTHON_BIN" ]] || PYTHON_BIN="$(command -v python3 || true)"` —— 找不到就静默退回系统 python3。
而本项目的 venv 由 update.sh 建在 `venv/`,不是 `.venv/`。我在开发机上 `ls -d venv .venv` 的结果是:只有 `.venv` 存在。也就是说这个 bug 在开发机上必然不可见,只在部署机上出现,并且伪装成"程序有 bug",让人先去翻 migrator 源码 —— 事实就是我们确实先在代码里找了一轮。
同一个晚上还有一条更尴尬的命令:`systemctl restart diag-push.timer` 返回 `Failed to restart diag-push.timer: Unit diag-push.timer not found.`
`diag-push.timer` 从来不存在过。真名是 `security-monitor-diag-report-push.timer`。7 处错名散在 6 个文件里:`sync_to_deploy.sh:62` 的 `--restart` 分支必然失败;`install.sh:213` 每次安装都 spit 一行 Unit not found;TUI 的 `status.py:273` 和 `others.py:962` 查的是 `security-monitor.timer`(这个 unit 也不存在,主守护进程只有 .service),所以两个面板恒显示 🔴;`uninstall.sh` 的停、禁、删三行永远是 no-op。
真正让我坐下来的是 204.C。审计顺手问了一句"`reputation_ban_threshold` 默认 55 是不是太高",我去读判定代码,只有两行:先 `score = self.get_score(ip)`,再 `if score < ban_threshold: return False`。
这两行意味着:阈值越大越难封禁。而 `BASE_SCORE = 50` 是"信誉库里没有这个 IP"时的默认分,fail2ban 和蜜罐发现的全新 IP 分数恒为 50。阈值 55 ⇒ 50 小于 55 ⇒ 走观察分支 ⇒ 永不封禁。阈值 40 ⇒ 50 大于 40 ⇒ 允许封禁。
用 `git log --grep='85.1'` 往回挖,指向 `0ad5fdd`,2026-09-06,Phase 85.1,commit message 写着「reputation_ban_threshold default 40→55 — 修复 P1 #5 反向 bug」。它把方向改反了,还自称在修反向 bug。从那天到 10-28,52 天。
更麻烦的是它周围长出了一整套"证据":`config.py:232` 的默认值 55 配一句反向注释「让 BASE_SCORE=50 的 IP 还能正常走封禁逻辑」(那句话描述的是 40 的行为);`config.py:712` 的 loader fallback 是第二个独立的 55(只改 dataclass 默认值不生效);`config.yaml.example:184` 值 55 且注释自相矛盾,上面三行写「IP 反复攻击但 daemon 永不 ban 就调低此值」,下面却写「必须大于等于 BASE_SCORE=50」。
修复:先让失败响亮,再让链路真的通
第一件事是把解释器探测改成候选列表:`$PYTHON_BIN` → `venv/bin/python3` → `venv/bin/python` → `.venv/bin/python3` → `.venv/bin/python`,每个候选都必须通过 `python -c "import yaml"` 才算可用;全都不行就 exit 2,逐条列出失败原因(不存在或不可执行 / 缺 PyYAML),并给三条修复命令。预检还挪到了备份之前 —— 原实现先备份后跑,失败会在部署机留一堆无用 .bak。
第二件事,unit 引用改成按动词语义分类的守卫:`restart / start / try-restart / enable` 引用的 unit 必须在 `systemd/` 目录里真实存在(硬故障);`stop / disable / status / is-active` 允许引用已删 unit(清理和诊断路径)。第一版规则是"任何被引用的 unit 都必须存在",一跑就多抓出 6 个引用,逐个核对后全是清理路径 —— 守卫的基准必须是 `systemd/` 里的真实文件列表,不是源码字符串。
第三件事,阈值默认值改回 40,并把周围 4 层证据全部反转:dataclass 默认值、loader fallback、`config.yaml.example`、`config_drift_audit.py` 的 `expected` 与 `check_fn`(`_int_at_least(50)` 换成新增的 `_int_at_most(50)`),以及两个测试文件里的 4 个反向断言。
其中最危险的是那个守卫脚本 `check_reputation_threshold.py`:它在正确配置 40 时报 WARN「高分 IP 走观察分支,永不封禁,部署机应 sed 到 55」。有人会说"守卫脚本嘛,响就响一下",但照着做那一步会把封禁真正关掉,而且日志会显示"警告已处理"。
第四件事是下游。Phase 205 一共 7 个 bug 叠在一起:`RecidiveConfig.enabled` 默认 False(loader 里还有第二处独立默认值,只改一处不生效)、`max_ban_count=3` 封顶让 tier[3]=30 天与 tier[4]=永久结构上不可达、观察期结束把计数清零成纯循环、playbook 的 `bantime` 是假值、`_ban_via_fail2ban(ip, bantime)` 收了 bantime 却从未在命令行里用过它、`jail.local` 的 `bantime.increment = true` 会在应用层下发值上再翻倍、以及"累计封禁恒 1"。
部署机的 ban_history.json 是铁证,1817 个 IP:
ban_count 分布: {0: 10, 1: 1152, 2: 468, 3: 187} >=4: 0 个
187 个 IP 精确卡在 count=3,这不是巧合,是 `max_ban_count=3` 的天花板。tier[3]=2592000 秒(30 天)和 tier[4]=2147483647(永久)从来没有被任何 IP 碰到过。
而第 5 条最要命:`bantime` 只出现在函数签名里,实际执行的命令是 `fail2ban-client set
第 7 条解释了用户最初的抱怨。`threat_intel.py` 里 `if self._ban_manager.is_ip_banned(ip): return True, "already_banned"` —— 一个已经封着的 IP 再攻击,函数返回了 banned=True,上层当封禁成功,于是推送「🔁 累计封禁 1 次 / 24h」,实际什么都没发生。这里我们刻意只改展示层:playbook 标 `_ban_already_active`,notifier 改文案「⏸️ 已在封禁中,本次未重复计数」并隐藏时长行 —— 把已有封禁算成新封禁会让 ban_count 虚增,比说谎更糟。
最后的分级序列是 24 小时 → 48 小时 → 7 天 → 30 天 → 永久,第 6 次转观察。剧本显式 bantime 与阶梯的合并按 `explicit * tier[count] / tier[0]`,count=0 时结果正好等于 explicit —— 首次封禁一秒不变,因为部署机 1817 个 IP 里有 1152 个还是首次。
结果:2131 passed / 2 skipped / 0 failed(HEAD `0136da1`),新增 38 项行为测试 + 17 组 drift 验证(每处改动单独篡改 → 精确打红 → 从源工作区恢复 → 全绿)。
反思:五个反直觉
其一,"零失败"是关于测试的陈述,不是关于系统的陈述。 10-26 的 1955 passed 是真的,10-27 和 10-28 部署机的 5 项失败也是真的。我一度以为这两件事矛盾,其实是我把"测试"和"监控"当成了同一根温度计 —— diag 报告测的是它自己那套脚本逻辑,修完 9 个 diag bug 之后报告更准确了,而报告更准确恰恰意味着它更能照出系统里原本被掩盖的坏。
其二,函数签名会撒谎,而且是最难被怀疑的那种。 `_ban_via_fail2ban(ip, bantime)` 这个名字在说"我按 bantime 封",代码里 bantime 一次都没进过命令行。没有任何类型检查、lint 或断言能抓这个,除非写一个"从真实执行路径读回实际时长"的测试。同理,`is_ip_banned` 返回 `banned=True` 是对"这个 IP 现在是封着的"的正确回答,但对"这次操作封成功了吗"是错误回答,而调用方只看到一个 bool。
其三,守卫脚本不是中立证人,它会把错误方向固化成待办事项。 4 层守卫加 2 个测试文件继承同一个反向语义,等于把 bug 编译进了契约。这也解释了 52 天为什么没人发现:不是没人看,是看的每一处都在告诉他"这是对的"。一条修错的 commit message 自带权威,会替后面所有人省掉重新推导的那一步。
其四,抓"假绿"比加"真绿"更值钱,但它需要双向的白名单。 Phase 205.B 用 AST 扫描器在 `tests/` 里抓到 5 条永远绿的测试,不是审计说的 2 条;多出的 3 条里有一条在 `tests/archive/`,我们默认 archive 不会被收集,实测 `--collect-only` 收到 7 条 —— archive 不是死文件。白名单必须双向:既"除白名单外不得新增",也"白名单条目必须仍然假",单向豁免会烂成永久免检。
其五,审计给的两个数字都得实测,而且都高估。 "事件写入 13GB/天"高估约 17 倍:审计用的是 `record_event()` 单条路径,而它在 `src/` 里没有任何生产调用者,生产走 `record_events(batch)`;单条路径每次都把整个 dedup 数组全量重写,是 O(N²),同样 22k 事件/天在真实路径上实测 742 MB/天,凑到 13GB 需要约 82 万事件/天。"quota 检查 96 秒"高估约 20000 倍:那段代码是纯磁盘 JSON 解析,1000 行实测 4.6ms;96 秒真正的来源是 VT 的 `_min_interval=15.0` 的 sleep 乘 6.4 次串行。但两个数字里仍有一个结构性问题是真的 —— dedup 重写占全天写入字节的 98.8%。
三天里最大的收获不是那 7 个 bug,是这条判据:一个功能"存在"和"工作"之间,可能隔着四层静默降级。每一层单独看都合理 —— gitignore 合理、fallback 合理、默认值合理、显式参数优先合理 —— 四层叠起来就成了"每次都封 24 小时,而推送说累计封禁 1 次"。下次再看到"配置改了没生效",我会先问一句:改的这份配置,最终是由谁执行的?它拿到的那个值,和推送里显示的那个值,是同一个吗?
评论区