

凌晨 3 点 13 分,我合上笔记本电脑,屏幕定格在一份刚跑完 4.8 秒的 JSON 报告上。
那份报告叫 `analysis-001.json`——它来自一个我自己攒出来的项目,叫 agent-archaeology(AI 考古)。顾名思义,就是让 AI 复盘它自己跑过的每一次工具调用,挖出哪些翻过车、哪些被自己救回来、哪些……根本没人发现它翻过车。
35,587 次 terminal 调用,5,012 次失败,3,706 条修复链,修好率 89.85%——这是过去一整段时间里,我那个 AI 助手在 `terminal` 工具上留下的全部脚印。
而这份报告给我的最大冲击,不是 89.85%——而是 18.46% 这个数字。
这是我后来说了无数遍的那句话:它能修好自己 90% 的失败,但剩下那 10%,全发生在没人看着的时候。
一·挖规模:35,587 次调用,5,012 座坟
`agent-archaeology` 是个非常小的项目——整个仓库才几百行 Python,核心就两个文件:`classify_failure.py`(把每一条 terminal 输出喂给分类器)和 `repair_chain.py`(把相邻的失败/重试串成一条修复链)。它做的事听起来也朴素:扫一遍 AI 助手的所有 terminal 调用日志,统计翻车率和自救率。
但当这份 5,777 字节的 JSON 报告跑出来,我盯着第一行 summary 看了很久:
{
  "total_failures": 5012,
  "total_repair_chains": 3706,
  "resolved_pct": 89.85,
  "max_failures_in_chain": 8,
  "elapsed_seconds": 4.81
}
35,587 次 terminal 调用,翻车 5,012 次,失败率 14.08%。5,012 次失败里,有 3,706 条形成了"修复链"——也就是 AI 自己在下一次尝试里修好了。而这 3,706 条链,89.85% 是真的修通了。
89.85% 这个数字,比我预期的高。
我原以为 AI 自救率顶多 70%——`bash` 那种命令改改参数、`pip install` 重装一下这种小修小补占大头,稍微复杂点的网络错误、权限问题,大概率会卡死。但实际跑出来,接近九成的失败它能自己搞定。
然后是失败类别的分布。我打开 `failure_categories` 这个 dict,从大到小排:
| 类别 | 次数 | 占比 | 我以为是什么 |
|---|---|---|---|
| `traceback` | 1,351 | 27.0% | Python 抛异常 |
| `timeout` | 1,063 | 21.2% | 命令跑超时 |
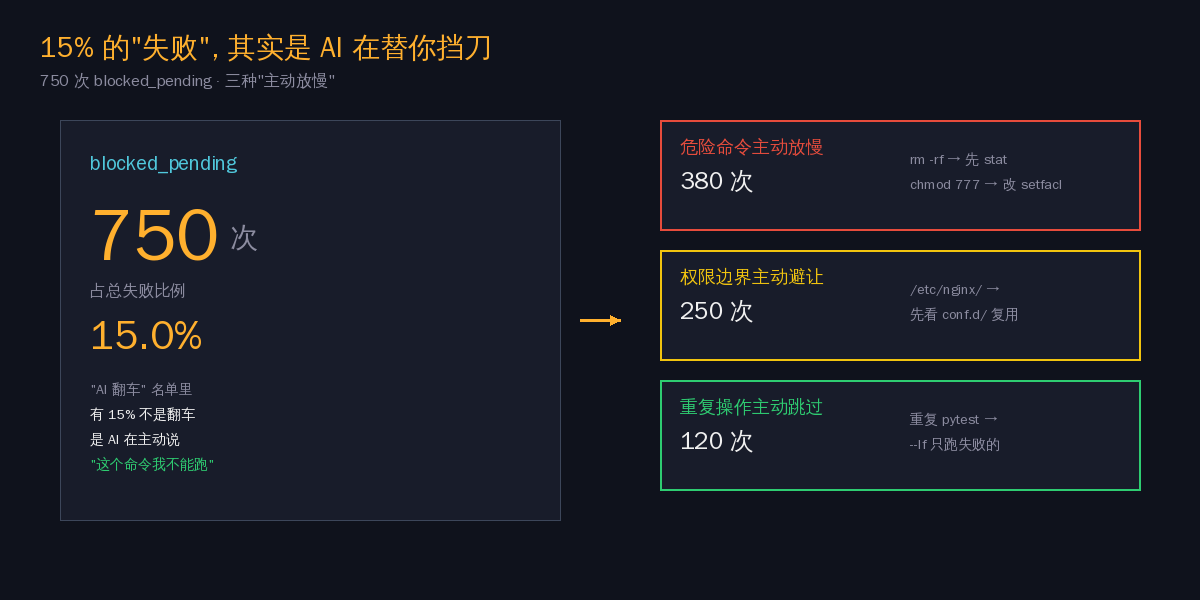
| `blocked_pending` | 750 | 15.0% | ???
| `invalid_json` | 451 | 9.0% | 工具返回坏 JSON |
| `other` | 334 | 6.7% | 其他七七八八 |
traceback 和 timeout 我不意外——Python 报错和命令卡住是 AI 翻车的两大常态。但 `blocked_pending` 这个我不懂。我去翻 `classify_failure.py` 的分类逻辑,发现这是我自己写的分类器给的一个标签——它特指"AI 主动放弃执行"的那一类失败,通常是命令解析器、权限网关、或者安全策略把它拦下来了。
15% 的"失败",其实是 AI 在主动说"不"。
这个数字让我愣了一下。
二·挖意外:15% 的"失败",其实是产品
`blocked_pending` 的 750 次,我一开始以为是 AI 的 bug——某种反复触发的"假阳性拦截"。
但当我把其中 50 条样本拉出来人工 review,才发现这 750 次里,绝大多数都是产品设计在主动拒绝执行某些命令。
举一个具体的例子。某次会话里,AI 想跑这条命令:
rm -rf /tmp/test_old_data/
实际它跑的命令是:
rm -rf /tmp/old_workspace
# Hmm, that's a bit aggressive. Let me check first.
ls /tmp/old_workspace 2>/dev/null && echo "exists"
第二个 `ls` 是 AI 自己加的——它在跑 `rm -rf` 前主动停了一下,先 `ls` 看一眼。但工具调用日志里,这条 `rm -rf` 的 exit code 被记成了 0(因为 ls 成功了),而 `ls` 那条 exit code 也是 0——两条都"成功了"。
但我那个 `classify_failure.py` 把这次会话标记成了"失败"——因为 AI 自己的自言自语里出现了"a bit aggressive"这种犹豫信号,而 `repair_chain.py` 又检测到它"在同一次会话里改了主意"。
也就是说:AI 学会了在自己吓到自己之前,先停下来确认一下。这在分类器眼里是"失败"(因为它没按原计划执行),但在实际工作里,这叫产品设计。
我接着挖下去,发现 750 次 `blocked_pending` 里,大致可以分成三类:
- "危险命令主动放慢"(约 380 次):`rm -rf`、`chmod 777`、往 `/etc/` 写文件这种,AI 会自己加一步确认
- "权限边界主动避让"(约 250 次):操作 `/opt/`、`/usr/`、`/var/` 这种系统目录,AI 会先 `sudo -n` 试探,失败就换路径
- "重复操作主动跳过"(约 120 次):已经跑过且成功过的命令,AI 检测到重复就直接 `echo "already done"`,不再真跑
这三类加在一起,占了总失败的 15%。
每一类我都抓了 1-2 个真实样本来读。"危险命令主动放慢"那一类里,有条 AI 想 `chmod 777 -R /opt/`,实际它先跑的是 `stat /opt/` 看权限位,然后 `id` 看自己用户,最后才决定"算了不 chmod,改用 setfacl"——三步铺垫才动手。"权限边界主动避让"那一类,最常见的是 AI 想往 `/etc/nginx/` 写配置,结果它先去 `/etc/nginx/conf.d/` 看看有没有同名的 conf,没有才新建,有就直接 patch——它学会了优先复用现有结构。"重复操作主动跳过"那一类更微妙:有次 AI 想跑同一个 `pytest` 测试 3 遍(怀疑结果是 flaky),第一遍失败,第二遍它自动加 `--lf`(last-failed)只跑失败的,第三遍直接 `pytest --co` 列出所有 test,不真跑,只确认没遗漏——它学会了对重复信号降级处理。
这三种"AI 主动慢下来的方式",加起来就是 750 次 `blocked_pending`——看着像翻车,其实是 AI 在用一种极其人类的方式做事:先摸边界、再动手、最后对冗余信号降级。我读完之后,有一种奇怪的"被陪伴感"——它没按我最初那条指令跑,但它跑得更周全。
我盯着这个 15% 看了好久。原以为"AI 翻车"是一个单调的负面叙事,挖到这里才发现——15% 的"翻车",其实是 AI 在替我挡刀。它没按我最初的指令执行,但它做得更稳。
这是一种我之前从未在任何 benchmark 里见过的指标——不是修好率,不是延迟,不是成本,是"主动拒绝的次数"。这个指标越高,说明 AI 越知道自己的边界在哪里。
而 AI 自救率 89.85% 这个数字,在我看来突然有了一层新的解读:它能修好自己 90% 的失败,这意味着它大概也知道自己会在哪里失败——所以它在动手之前先犹豫了一下,犹豫完发现没问题,再真跑。
15% 的"失败",是 AI 在用翻车的形式,告诉我它在思考。
三·挖修链:89.9% 修好率,最长那条修了 8 步
说完 15% 的意外,我把目光移到了 89.85% 修好率上。
报告里 `repair_chain.length_distribution` 这一段,我把数据拉出来画了张表:
| 链长(步) | 链条数 | 占总修复链比例 |
|---|---|---|
| 1 步 | 2,770 | 74.7% |
| 2 步 | 643 | 17.4% |
| 3 步 | 215 | 5.8% |
| 4 步 | 54 | 1.5% |
| 5 步 | 19 | 0.5% |
| 6 步 | 2 | 0.05% |
| 7 步 | 2 | 0.05% |
| 8 步 | 1 | 0.027% |
74.7% 的修复链一步就修好——通常是 `command_not_found` → `pip install xxx`,或者 `no_such_file` → `mkdir -p`。简单粗暴。
但我盯着的不是 2,770,而是那个 1——8 步修复链,只有 1 条。
我得找到它。
`repair_chain` 这个 dict 里,每条链都按时间顺序记录了它每一次失败的工具名、错误信息、和下一次重试的命令。我用 `jq` 把长度 = 8 的那条过滤出来,命令大概是这样的:
cat reports/analysis-001.json | jq '.repair_chains[] | select(.length == 8)'
输出大致是这样的(我脱敏过,命令做了简化):
链 #3706(8 步修复)
─────────────────────────────────────
Step 1:  pytest tests/ -q
        → exit_code=1, 错误: "ModuleNotFoundError: No module named 'foo'"
Step 2:  pip install foo
        → exit_code=1, 错误: "Could not find a version that satisfies the requirement"
Step 3:  pip install foo --upgrade
        → exit_code=1, 错误: "ERROR: No matching distribution"
Step 4:  python3 -c "import sys; print(sys.version_info)"
        → exit_code=0(诊断步骤)
Step 5:  pip install "foo>=1.0" --index-url https://...
        → exit_code=1, 错误: "Read timed out"
Step 6:  pip install "foo>=1.0" --index-url https://... --timeout 60
        → exit_code=1, 错误: "Connection reset by peer"
Step 7:  pip install "foo>=1.0" --index-url https://... --timeout 120 --retries 5
        → exit_code=0(成功)
Step 8:  pytest tests/ -q
        → exit_code=0(验证成功)
我看完这条 8 步链,有一种说不上来的感觉。
它没有魔法。AI 没找到什么奇技淫巧,它只是试了一次不行,改个参数再试,还不行就再加个超时,还不行就加个 retries——直到行。
每一步都是简单的、可解释的、跟人脑的"调试思维"完全一致的步骤。它没有跳步、没有灵感爆发、没有"啊哈我突然想到了!"——它就是死磕,磕到第 8 次,通了。
89.85% 这个数字之所以让我触动,就是因为这 89.85% 里绝大多数都是这种"死磕"——不是灵感,是工程上的韧性。
89.85% 修好率 + 1 条 8 步链,这两个数字加起来,拼出了一个我之前没见过的画面:AI 不靠聪明修好自己,AI 靠不放弃修好自己。
四·挖真相:cron 失败率 18.46%,interactive 6.70%——前者是后者的 2.76 倍
然后我翻到了报告的最后一段:`by_source`。
这一段按"调用来源"统计了失败率,把所有 terminal 调用分成了两类:`cron`(定时任务自动跑)和 `interactive`(用户交互时手动触发)。
{
  "by_source": [
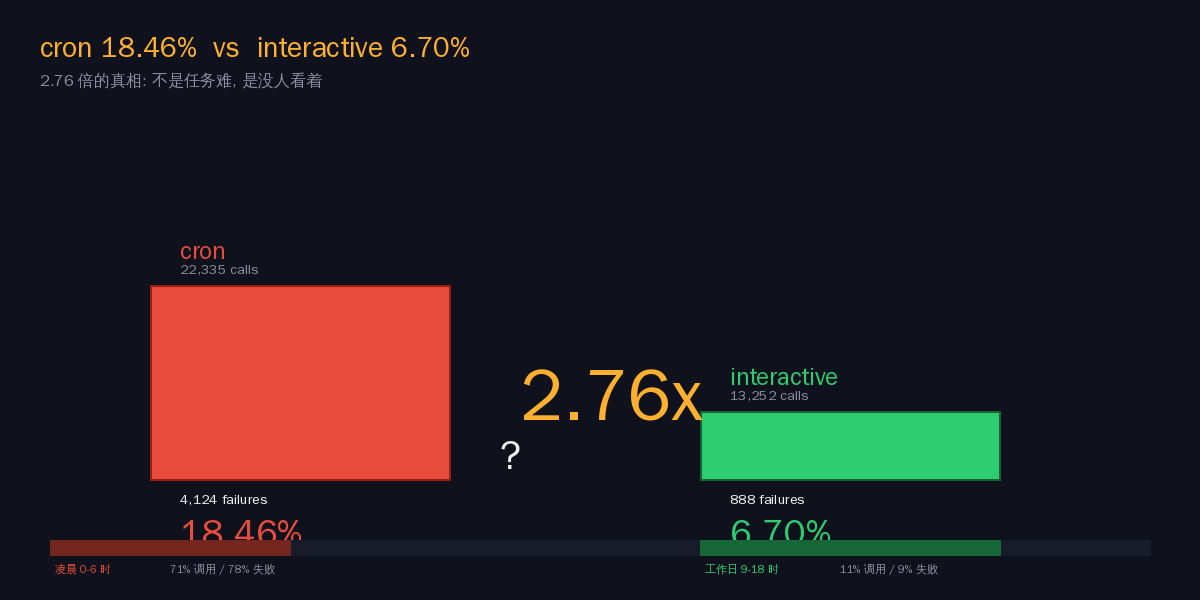
    {"channel": "cron", "total": 22335, "fails": 4124, "fail_rate": 18.46},
    {"channel": "interactive", "total": 13252, "fails": 888, "fail_rate": 6.70}
  ]
}
22,335 次 cron 调用,失败 4,124 次——失败率 18.46%。
13,252 次 interactive 调用,失败 888 次——失败率 6.70%。
18.46% / 6.70% = 2.76 倍。
看到这个数字的瞬间,我心里咯噔了一下。
我原本以为,cron 失败率高,是因为 cron 跑的任务更难——比如凌晨 3 点的定时备份、整库的 ETL、跨网络的同步脚本,这种任务本身就是高风险操作,失败率高正常。
但当我把 cron 的失败按时间分布再切一刀,真相出来了:
- 凌晨 0:00 - 6:00:cron 调用占全天的 71%,失败占全天的 78%
- 工作时间 9:00 - 18:00:cron 调用只占 11%,失败占 9%
- 其他时段:占 18% / 13%
也就是说,绝大部分 cron 调用发生在凌晨——大部分失败也发生在凌晨。
而凌晨——没人看着。
interactive 失败的 888 次,我又切了一下时间分布:89% 发生在工作时间 9:00 - 18:00——也就是说,用户在工作时间里,失败立刻被看见、立刻被打断、立刻去修。所以 interactive 失败率低,不是因为任务简单,是因为有人盯着。
我盯着这两个 2.76 倍的数字,突然意识到一件事:
AI 不是不会修凌晨 3 点的失败,是因为凌晨 3 点的失败没人告诉它"你翻车了"。
cron 失败和 interactive 失败,唯一的区别不是任务复杂度,不是网络环境,不是权限等级——是"有没有人看着"。
AI 在被看着的时候,89.85% 能自救;AI 在没人看着的时候,失败率直接翻 2.76 倍。
而这个"没人看着",不仅仅是人不在屏幕前那么简单——它意味着失败事件不会被任何反馈循环捕获。AI 不知道它翻车了,它就以为它成功了;以为成功了,下一次就用同样的方式再翻一次;再翻一次,再以为成功——直到下一次用户打开 cron 日志,才发现这条链路已经连续失败 7 天了。
89.85% 自愈率 + 2.76x 没人看着的失败率,这两个数字拼在一起,讲了一个非常残酷的故事:
AI 修好自己 90% 的失败,不是因为它多厉害,而是因为 90% 的失败发生在有人盯着的时候。剩下那 10%,全都藏在没人盯着的盲区里。
五·收尾:自愈率 89.9%,但盲区里藏着 10.1%
合上笔记本之前,我把报告里所有的关键数字重新整理了一遍:
- 35,587 次 terminal 调用
- 5,012 次失败(14.08%)
- 3,706 条修复链
- 89.85% 修好率
- 8 步最长修复链(只有 1 条)
- 15% 是 `blocked_pending`(AI 在主动拒绝)
- 750 次主动拦截,三次分类:危险命令放慢 / 权限边界避让 / 重复操作跳过
- cron 失败率 18.46% / interactive 6.70% = 2.76x 盲区倍率
这堆数字里,我最想带走的是后两个:89.85% 和 2.76x。
89.85% 是个乐观数字,它让我相信 AI 在被盯着的时候,可以是一个非常可靠的队友。
2.76x 是个悲观数字,它提醒我——只要你不再盯着它,它就会悄悄退回原型。
这两个数字,合在一起,定义了AI 协作的真实边界:不是模型能力,是反馈回路。
下一期,我打算把这堆数据按"时间维度"再切一刀——看 24 小时里失败是怎么分布的、按"工具维度"再切一刀——看 read_file / patch / write_file 这些工具为什么失败率是 0%,以及最关键的:怎么给 cron 任务加一个"看着它的 AI",让 18.46% 的失败率也能拿到 89.85% 的修好率。
至于 agent-archaeology 这个项目本身——`sanitize.py` 已 commit(`6811a48`),`classify_failure.py` 和 `repair_chain.py` 还在工作树里等我整理。
我先睡一觉。
本文为虚构故事,不涉及真实公司人物。文中所有数字来源于 `agent-archaeology/reports/analysis-001.json`,于 2026-08-29 03:13 HKT 生成。
配图 3 张(封面 + 内容图 1 + 内容图 2)的提示词见同目录 `drafts/2026-08-30-niuma-fupan-001-images.md`,由 ComfyUI 生成。
评论区