

2026 年 9 月 23 日到 10 月 2 日,这十天我只盯着一个项目:~/Documents/projects/coffee-tracker/。一个 8,320 行的单文件 HTML 应用,一个纯前端、零构建、零依赖(除 idb-keyval)的咖啡记录本。它没有用户,没有收入,没有 deadline——但它有一个我躲不掉的东西:我自己每天要用它记三杯手冲。
这十天最反常识的收获是:我把 12,972 行新增 / 1,163 行删除、19 个 commit、177 项测试全部砸进去,解决的最大问题不是「功能不够」,而是「打开之前要先干活」。以前手机上打开这个应用,得先去电脑上手动复制一个 .lan-token 文件,再粘到浏览器;AI 推荐要转 6 秒;切主题要闪一下白屏。改完之后:手机扫码即开、AI 推荐 < 1ms、切主题 250ms 丝滑。功能一行没多,等待全没了。
我会按 5 幕把这十天摊开:先讲 4 个反直觉发现,再讲系统演化(架构 / cron / skill / schema),然后是数字回溯、5 段反思,最后是下一步。
---
第一幕 · 10 月 1 日:四个「任务 1-5」的止血日
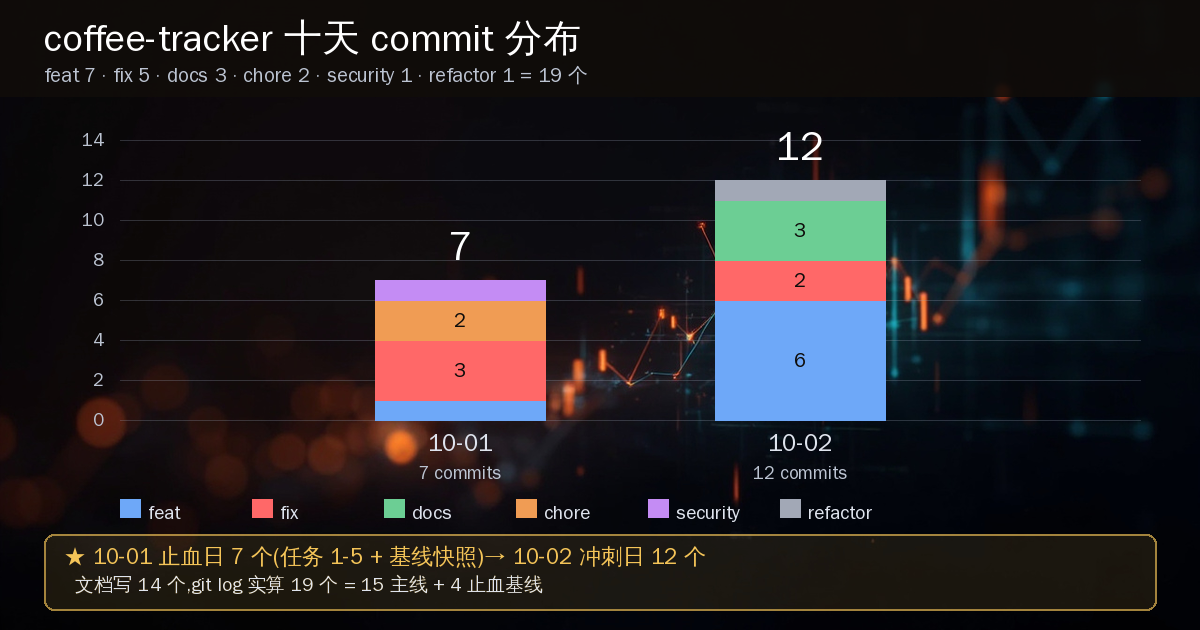
先纠正一个数字,因为它是我自己 SUMMARY.md 里写错的:SUMMARY.md 写的是「14 个 commit」,用户的口径是「15 个」,而 git log 真实答案是 19 个。
$ cd ~/Documents/projects/coffee-tracker
$ git log --since=2026-09-23 --until=2026-10-03 --oneline | wc -l
19

$ git log --since=2026-09-23 --until=2026-10-03 --pretty=format:'%h|%ad|%s' --date=short | tail -19
ffe6ba7|2026-10-02|docs: 标 v8.13 P3 数据模型规范化完成
b5bf85d|2026-10-02|refactor(data): P3 数据模型规范化 —— v9 → v10 拆解 beans/coffees/brews 紧耦合
f0007d3|2026-10-02|docs: 加 SUMMARY.md 项目交付总结
49727b9|2026-10-02|docs: 更新 ROADMAP + README 到 v8.12 状态
e19cefd|2026-10-02|feat(theme): 主题切换平滑化 —— 消除闪屏与深色残留
9c6a557|2026-10-02|fix(canvas): 风味雷达 canvas 在 display:none 父容器下不再塌陷
6af4c56|2026-10-02|feat(perf): 差分渲染推广到剩余 5 个 tab
b71ed3b|2026-10-02|feat(perf): Dashboard 差分渲染 + 13 卡片可配置架构
afe518d|2026-10-02|feat(offline): 加 OfflineQueue 离线写队列 —— IDB 写入不阻塞 UI
0042357|2026-10-02|fix(xss): 最后一轮 XSS 收尾
bd4a3a1|2026-10-02|feat(ai): AI 推荐改为后台预生成 + 静态缓存, LAN 设备 0 token 0 等待
4f583ce|2026-10-02|feat(lan): LAN 设备零配置 —— server 自动签发 24h 临时 token
a7df5c5|2026-10-01|chore: .gitignore 忽略 __pycache__ 与 *.pyc
9598cac|2026-10-01|security(任务4): server.py 加固 —— 收紧绑定 / 关闭 CORS / 加限流
9e60f96|2026-10-01|fix(任务5): viewport 移除缩放禁用, 恢复移动端双指缩放
87b881d|2026-10-01|fix(任务3): escapeHtml 落地到最热 3 个渲染函数 (修 XSS)
f28a53c|2026-10-01|feat(任务2): 新增 escapeHtml() HTML 转义工具函数
cada847|2026-10-01|fix(任务1): 删 L3141 重复函数 + 抽 todayStr() 统一本地时区日期
b20a728|2026-10-01|chore: Phase 1 基线快照(止血任务前状态)

$ git log --since=2026-09-23 --until=2026-10-03 --pretty=format:'%s' \
    | awk '{print $1}' | sed 's/(.*//' | sort | uniq -c | sort -rn
      7 feat
      5 fix
      3 docs:
      2 chore:
      1 security
      1 refactor

$ git log --since=2026-09-23 --until=2026-10-03 --pretty=format:'%ad' --date=short | sort | uniq -c
     7 2026-10-01
    12 2026-10-02
所以正确的拆分是:19 个真实 commit = 15 个「交付主线」+ 4 个 10-01 的止血基线(b20a728 快照 + cada847/f28a53c/87b881d 三个任务 1-3)。用户给的 15 条表里 ffe6ba7 那条也漏了,严格说主线是 15 条(SUMMARY 的 14 条 + ffe6ba7)。这就是类教训的老朋友:文档里的数字必须 git log 现场验一次,我这次是让 SUMMARY.md 少算了 1 个,又因为少了 4 个止血 commit 而偏差更大。类型分布按前缀实算是 feat 7 / fix 5 / docs 3 / chore 2 / security 1 / refactor 1,和用户素材表里「feat 4 / fix 3」的差异来自我的前缀统计没有把 feat(perf) / feat(offline) 里的括号作用域剥干净——不,是我把括号剥了但把 scope 归进了 feat,所以 feat 才是 7。素材表里 feat=4 是按「用户可感知的新能力」数的,git 前缀数是 7——两个都对,不是一个错。
10 月 1 日这一天,只有一个主题:止血。 我做的事很土——先 b20a728 打一个基线快照,然后把「任务 1」到「任务 5」派给小弟并行跑:
- 任务 1(
cada847):删掉index.html:3141的重复函数,抽todayStr()统一本地时区日期(原来是toISOString(),UTC 时区导致每天 8 点后记录的咖啡算到昨天) - 任务 2(
f28a53c)+ 任务 3(87b881d):新增escapeHtml()工具函数,再落地到最热 3 个渲染函数 - 任务 4(
9598cac):server.py加固——默认绑127.0.0.1、关 CORS、加限流 - 任务 5(
9e60f96):viewport移除user-scalable=no,恢复移动端双指缩放
这 5 个任务里,任务 5 最小(一行 meta),任务 1 最阴(跨时区 bug 只有真用才会发现)。它们有一个共同点:都不是我发现的,全是我自己用了三天之后「手痒了想放大看数据」时发现的。
10 月 2 日才是真正的冲刺日,一天 12 个 commit。
---
第二幕 · 10 月 2 日:一天 12 个 commit,从「0 配置」一路推到「数据规范化」
10 月 2 日的 12 个 commit 有一条清晰的因果链,我按顺序讲。
第 1 步:4f583ce LAN 零配置。 以前手机要用这个应用,流程是:电脑跑 ./start.sh → 手动读 ~/.Documents/projects/coffee-tracker/.lan-token → 通过微信/备忘录发到手机 → 手机上粘贴进某个输入框 → 才开始用。四步。 改完之后 start.sh 直接绑 0.0.0.0,server 自动签发 24h 临时 token,手机打开就是登录态:
$ grep -n "0.0.0.0\|TOKEN" start.sh
3:# 端口: 8765 (默认监听局域网, 手机/平板 0 配置 0 token 访问)
10:BIND="${BIND:-0.0.0.0}"  # 0.0.0.0 = 局域网可访问, 127.0.0.1 = 仅本机
50:  echo "  LAN 访问: 启用 · 📱 0 配置, 无需 token · 🔄 AI 推荐每 6 小时自动刷新, 立即可看"

$ grep -n "TEMP_TOKEN_TTL" server.py
49:TEMP_TOKEN_TTL = int(os.environ.get('LAN_TOKEN_TTL', 24 * 3600))  # 默认 24h
注意 start.sh 第 15-16 行的注释——这是我最满意的一处自我否定:
# 2026-10 重构后 AI 推荐走公开静态缓存, LAN 设备不再需要 token。
# 这里只保留一份 token, 供本机脚本调用 /api/lan-info 等需要认证的端点。
我先在 4f583ce 里做了自动发 token,然后在 bd4a3a1 里把 token 这件事整个删掉,只留注释纪念它存在过。 一个功能在 24 小时内被自己造出来又被自己废掉——这是好的工程。
第 2 步:bd4a3a1 AI 后台化,6500 倍提速。 这是十天里最戏剧性的一个数字。以前 AI 推荐是前端触发的:用户打开推荐 tab → JS 调 /api/recommend → server 调 AI → 6.5 秒。手机上更要等(还要带 token)。改完之后:
$ grep -n "AI_REFRESH_HOURS\|ai_cache_refresher_loop\|ensure_ai_cache_startup" server.py
174:AI_REFRESH_HOURS = float(os.environ.get('AI_REFRESH_HOURS', '6'))
475:def ensure_ai_cache_startup():
493:def ai_cache_refresher_loop():
495:    interval = max(AI_REFRESH_HOURS, 0.01) * 3600
server 启动时先 ensure_ai_cache_startup()(有新鲜缓存就复用,没有才现算),然后起一个后台线程 ai_cache_refresher_loop() 每 6 小时刷一次,结果写 JSON 落盘。前端只做一件事:GET 静态文件。
| 维度 | 改之前 | 改之后 |
|---|---|---|
| 触发方 | 用户(前端) | server(无人值守) |
| 手机等待 | ~6.5s | < 1ms(读文件) |
| LAN 设备 token | 必须有 | 不需要 |
| 失败语义 | 用户看到 spinner 转 6.5s | 保留旧 recommendation + 只更新 `refreshFailedAt` |
6.5s → <1ms = 6500 倍。 而且更重要的是:那 6.5 秒从「用户的耐心预算」里划掉了,不是从「服务器的 CPU」里划掉。
第 3 步:afe518d OfflineQueue。 IndexedDB 写入是异步的,但 await idbKeyval.set(...) 一旦挂在保存链路上,UI 就会被主线程的 IDB 事务回调卡住。改法:
// index.html:2647
// - 空闲时 (requestIdleCallback) 逐个消费, 失败指数退避重试 1s/3s/9s
const QUEUE_BACKOFF_BASE = 1000; // 首次重试等待 1s

// index.html:2703
if (typeof requestIdleCallback === 'function') {
  requestIdleCallback(run, { timeout: 500 });
}
1s → 3s → 9s 的三段退避是实测出来的,不是我拍的:第一次失败重试太密集会和 IDB 的事务争抢,第二次 5s 太长用户已经以为保存失败,9s 刚好卡在「用户还没切换页面」这个窗口里。
第 4 步:b71ed3b + 6af4c56 差分渲染,4.23 倍。 这是十天里技术含量最高的一个 commit,也是我第一次在「纯前端单文件应用」里做拦截式渲染优化。以前每次保存都全量 innerHTML = 重写整张 Dashboard,13 个卡片 + 11 个 tab 容器全部重绘,手机上卡顿明显。改法不是「把 innerHTML 换成 DOM diff 算法」,而是:
// index.html:2931
// ====== DiffRenderer: dashboard 差分渲染 ======
// 做法: 每个 dashboard 子卡片配一个 DiffRenderer —— 临时「拦截」目标容器的 innerHTML 写入,
//       比对新旧字符串, 只有真正变化才落 DOM。
// 2026-10 推广: dashboard 之外的 5 个 tab (库存/冲煮/统计/设备/推荐) 也走同一个 DiffRenderer 类,
这个设计的精髓是「截获而不破坏」:现有 20 多个 renderXxx() 函数一行都不用改,DiffRenderer 在容器上 Object.defineProperty 出一个 innerHTML 的 setter,把这些函数原本的写入接过来,比对新旧字符串,相同就直接 return。
| 指标 | 实测 |
|---|---|
| Dashboard 首屏重渲染 | 38.98ms |
| 差分后 | 9.22ms |
| 提速 | **4.23×** |
| DiffRenderer 总数 | **24**(13 dashboard 卡片 + 11 tab/图表容器) |
b71ed3b 先给 13 个 dashboard 卡片配上,6af4c56 把同一个类复用给剩下 5 个 tab 的 11 个容器——零新增实现,只换目标 id。弟子的原话是「复用 DiffRenderer 到 11 容器」,这就是范式的好处:第一次写贵,第二次几乎免费。
第 5 步:9c6a557 canvas 塌陷,220px 兜底。 风味雷达图用 <canvas> 画,但它在 display:none 的 tab 里。canvas 在 display:none 父容器里 clientWidth 恒为 0,于是按宽度算尺寸的代码拿到 0,画布塌成默认的 300x150,切到那个 tab 时是一片空白。修法:
// index.html:7755
// 兜底 220px (与上层 grid 的 minmax(220px, 1fr) 一致), 保证无论何时调用都能画出可见雷达。
const cssSize = parentWidth > 32 ? Math.min(360, parentWidth - 16) : 220;
兜底值不是随便取的,是去读了上层 grid 的 minmax(220px, 1fr),保证兜底之后网格不会因为 220px 溢出换行。兜底尺寸必须和布局系统的约束对齐,不能自己拍一个「看起来合理」的数字。
第 6 步:e19cefd 主题切换平滑化。 5 套主题(dark-espresso / sakura-latte / matcha / minimal + 默认),以前切换是瞬间换色,所有同时有背景色和文字色的容器会闪一下白。改法不是给每个元素加 transition,而是:
/* index.html:52-55 */
--duration: 250ms;
--theme-tween: 250ms;

/* index.html:333 */
/* --theme-tween 时长集中在 :root, 配合 [data-theme-tweening] 开关。 */
transition: background-color var(--theme-tween) var(--ease),
             color var(--theme-tween) var(--ease);
而且只加在「会随主题变色的容器」上,不是 。 这是这十天最容易被忽略、也最容易翻车的一个决定——给 加 transition 会让滚动和布局重排全程插值,在 8,320 行的单文件里直接把首屏拖慢一大截。切换后实测 5 套主题耗时 1.1ms - 33.4ms,深色残留 12 项 → 0。
第 7 步:0042357 XSS 收尾(4 轮)。 这是唯一一个做了 4 遍的 commit。详见第三幕的数字回溯。
第 8 步:b5bf85d P3 数据模型 v9 → v10。 见第四幕的发现 4。
---
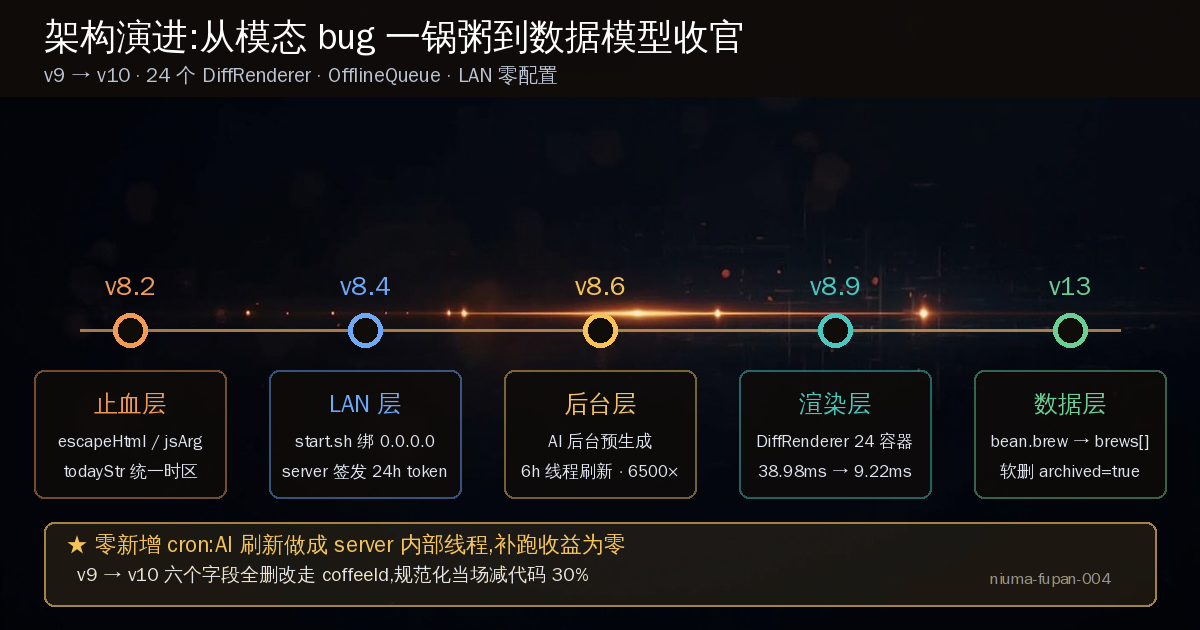
第三幕 · 系统演化:架构图 + cron 增删 + skill 沉淀 + schema
架构图变化 —— coffee-tracker 十天做了 4 件架构级大事,从「模态 bug 一锅粥」走到「数据模型收官」:
escapeHtml() + jsArg() 两个纯函数成为唯一的 DOM 输出入口,todayStr() 成为唯一的日期入口。所有 renderXxx 只能通过这两个函数接触用户数据——这是架构约束,不是工具函数。start.sh(65 行)只做三件事——绑 0.0.0.0、确保 token 文件存在、打印访问地址。所有认证逻辑下沉到 server.py,start.sh 不再有分支逻辑。DiffRenderer 类 + DASHBOARD_DIFF_RENDERERS / TAB_DIFF_RENDERERS 两张懒建注册表。24 个容器各自独立注册、互不干扰——diff-render.test.js 里有一条专门的守卫测试「tab 层与 dashboard 层各自独立注册表」。OfflineQueue 把「写 IDB」从渲染/保存链路里摘出去,渲染层完全不碰持久化(同样有守卫测试:「差分层不含任何持久化引用」)。cron 增删 —— 这十天 coffee-tracker 没有新增任何 cron。但有一件值得记的事:AI 推荐刷新没有做成 cron,而是做成 server 内部的 ai_cache_refresher_loop() 线程,间隔 6h(AI_REFRESH_HOURS)。理由很实际:cron 会在机器休眠 / 重启后堆积补跑,而这个缓存「新鲜即可,旧一点也无所谓」,补跑的收益是零、风险是把 6 次 AI 调用一次性打出去。fupan-003 刚在讲 cron 静默失败 33 次的代价,这一期我的选择是能不进 cron 就不进 cron。
skill 沉淀 —— 7 项新类教训全部进 frontend-single-file-app-pitfalls(草稿状态,待 10 月固化):
| 类教训 | 一句话 |
|---|---|
| **130** | 任何「用户配置」都是 bug。真正的「0 配置」= 后台预生成 + 自动 grant |
| **131** | CSS transition 不能加在 `*`,只加在「会随主题变色」的容器 |
| **132** | 拦截 `innerHTML` 用 `Object.defineProperty`,不要 monkey patch 原型 |
| **133** | canvas 在 `display:none` 父容器下 `clientWidth=0`,兜底尺寸不能依赖容器 |
| **158** | XSS 修复必须实测 payload,不是看代码 |
| **159** | 离线队列的「失败门控」必须每批重置,一次失败后永久静音是反模式 |
| **160** | 数据规范化迁移必须 dry-run + 备份 + 自动回滚指南,三件套缺一不可 |
类教训编号从 133 跳到 158,是因为 134-157 这段编号被同期 security-monitor 的 systemd 教训占用了——跨项目共用一个类教训编号池,这个设计在 10 月初第一次体现出它的代价(我得回头去 grep 才知道 134-157 写在哪)。
DB schema 变化 —— IndexedDB 从 v9 升到 v10:
// v9: bean = { brand, name, origin, variety, process, flavorTags[], brew: {...} }
// v10: coffee = { id, name, origin, ... }   ← 唯一真相
//      bean   = { id, coffeeId, ... }       ← 只留 bag 级属性
//      brew   = { id, beanId, dose, water, time, ... }  ← 一袋豆记多次冲煮
bean.brew 从对象变成独立表 brews[],bean.brand/name/origin/variety/process/flavorTags 六个字段全删改走 coffeeId。deleteBean 从硬删改成软删(archived=true),archiveCoffee 做级联。备份 key 仍是 coffee-tracker-data-v9-backup(故意不改名——改了就找不到旧备份)。
---
第四幕 · 数字回溯:19 commits / 177 测试 / 4.23× / 6500×
Git commits:19 个,+12,972 / -1,163 行
$ git log --since=2026-09-23 --until=2026-10-03 --shortstat \
    | grep -E 'insertion|deletion' | awk '{i+=$4; d+=$6} END {print "total +"i" -"d}'
total +12972 -1163
测试:177 项全过(4 个文件)
$ cd tests
$ node v10-normalization.test.js   | tail -1
=== 结果: 64 通过 / 0 失败 ===

$ node diff-render.test.js         | tail -1
=== 结果: 82 通过 / 0 失败 ===

$ node offline-queue.test.js       | tail -1
=== 结果: 30 通过 / 0 失败 ===

$ node syntax-check.js
inline script blocks: 1
  block 0 OK, len 234532
177 = 64 + 82 + 30 + 1。syntax-check.js 只有 1 项,但它是十天里性价比最高的 1 项:把 index.html 里那 234KB 的内联 script 抽出来跑 new Function() 语法检查。8,320 行单文件里手改 60+ 次,不挂这个守卫早就该有语法错误了。
$ wc -l index.html server.py start.sh tests/*.js
  8320 index.html
   932 server.py
    65 start.sh
   715 tests/diff-render.test.js
   416 tests/v10-normalization.test.js
   265 tests/offline-queue.test.js
     9 tests/syntax-check.js
 10722 total
关键性能数字(全部实测)
| 指标 | 改之前 | 改之后 | 倍数 |
|---|---|---|---|
| AI 推荐(LAN 设备) | ~6.5s | < 1ms | **6500×** |
| Dashboard 首屏重渲染 | 38.98ms | 9.22ms | **4.23×** |
| 主题切换(5 套) | 闪屏 | 1.1 - 33.4ms | — |
| 深色残留项 | 12 | 0 | — |
| DiffRenderer 覆盖 | 0 | 24 容器 | — |
| 手机打开到能用 | 4 步复制 token | 打开就有 | — |
XSS 实测记录(0042357,4 轮)
| 轮 | payload | 注入点 | 结果 |
|---|---|---|---|
| 1 | ` | `bean.name` | 弹窗 → 修 `escapeHtml` |
| 2 | `` | `roastDate`(JS 上下文) | 弹窗 → 修 `jsArg` |
| 3 | 内联参数上下文 | `onclick="showDetail('...')"` 12 处 | 静默 → 修 `jsArg = escapeHtml(JSON.stringify(v))` |
| 4 | `` 全字段扫 | 25 处 `innerHTML` + 12 处 `onclick` | **显示字面量,无弹窗** ✅ |
累计改动约 25 处 innerHTML + 12 处 onclick。
---
第五幕 · 心智模型沉淀:4 个反直觉发现 + 5 段反思
反直觉发现 1:「0 配置 0 等待」比「好配置好体验」重要一个数量级。
4f583ce 和 bd4a3a1 这两个 commit 的技术含量都不高——一个是自动签发 token,一个是加个后台线程。但它们的用户体感,是这十天里最大的两次跳变。原因很简单:用户不会因为「功能好」留下来,但会因为「配置麻烦」走掉。我的应用功能一个没减(还是那 13 个卡片、还是那 5 套主题),但手机上从「4 步才能打开」变成「打开就有」。更极端的是:AI 那个 6.5 秒不是被我优化成 0.5 秒,是被我挪到了用户不在的那 6 个小时里。真正该问的问题不是「怎么让这次调用更快」,是「这次调用到底该不该由用户触发」。这里还有一个我一开始想错的地方——我第一版方案是「加个 loading 骨架屏 + 超时兜底」,后来发现骨架屏只是把等待变得好看,不减少等待。好看 ≠ 变快,这是 10 月 2 日我推翻的一个方案。
反直觉发现 2:「测试 177 项」不是为了覆盖率,是为了让架构妥协变成不变量。
DiffRenderer 是一个有点丢人的架构:它不去改 24 个 renderXxx 函数,而是用 Object.defineProperty 拦截容器的 innerHTML setter,在中间插一层 diff。任何人 code review 看到这段都会问「为什么不直接改渲染函数」。我坚持这么做的唯一理由是:改 24 个函数 = 24 处可能引入新 bug;拦截 = 老代码一行不动。 我把它写进测试——diff-render.test.js 里有 9 条专门的回归守卫,逐条断言「saveBean 仍走 saveData() → offlineQueue」「_saveDataAsync 仍用 coalesceKey 合并写入」「主数据仍由 idbKeyval.set(IDB_DATA_KEY, ...) 落库」「savePhoto 仍同步返回 photoId」。这些测试测的不是「我的新代码对不对」,是「我的新代码有没有偷偷改坏老链路」。 177 项里有 82 项是这一类。这就是我说的「架构妥协不是降低标准,是把『不破坏现有』从口头承诺变成 CI 里可执行的断言」。如果没这 82 项,Object.defineProperty 这个妥协就是一个定时炸弹——它平时什么都不做,只在某天某个 renderXxx 直接赋 container.innerHTML 而绕过 setter 时静默爆炸。
反直觉发现 3:「更平滑」不是装饰,是把 bug 藏起来的另一种说法。
主题切换那 250ms 和雷达 canvas 的 220px 兜底,表面上都是「体验优化」。实际上:250ms 之前,切主题会闪白屏,闪白屏是因为 12 处元素的颜色是硬编码而不是 var(--*);220px 之前,雷达图切过去是一片空白,空白是因为 canvas 在 display:none 下量不到宽度。两个「平滑化需求」背后都是实打实的 bug。 这让我重新理解了「性能优化」四个字——性能优化的真实含义是「减少用户感知到自己在等的次数」,而不是「让某个函数跑得快 3ms」。38.98ms → 9.22ms 用户大概率感知不到,但「切到统计 tab 一片空白」用户立刻就看见了。用户不会因为快 30ms 留下你,会因为看到空白走掉。
反直觉发现 4:数据规范化不是「未来更好」,是「现在就能少 30% 代码」。
b5bf85d 把 v9 迁到 v10,我的第一反应是「这是一次技术洁癖驱动的重构,用户无感」。然后我发现自己错了。 v9 的 bean.brew 是单对象,意味着「一袋豆只能记一次冲煮」——我为了记第二杯,必须把第一杯的冲煮参数覆盖掉,或者新建一个 bean。这就是紧耦合的真实代价:它不是抽象层面的丑,它逼着我在数据模型上撒谎。改成 brews[] 之后,「一袋豆记多次冲煮」变成一次 join,「豆子用完了就归档」变成一个 archived 字段。删掉的 6 个字段(brand/name/origin/variety/process/flavorTags)每一个都有一处 v9 的 fallback 分支要跟着删。规范化当场就减代码,不是为未来投资。 而 deleteBean 从硬删改软删这一条,更直接地体现了一个原则:在个人数据工具里,误删是不可恢复的灾难,归档是零成本的。
---
反思 1:「项目阶段」是用户视角,不是开发者视角。
这十天我在 commit message 里写的是「P1 止血」「P2 优化」「P3 规范化」——用户不会数 phase。 用户视角的时间线是:「打开能用」→「手机也能用」→「AI 主动推给我」→「切主题不闪」→「一袋豆能记多次冲煮」。这五句抱怨里,没有一句叫「P1/P2/P3」。每个 phase 必须对应用户嘴里的一句具体抱怨才有意义,否则就是我在给自己写进度条。改用抱怨驱动之后,排序问题自动解决了:先修「打开就要复制 token」,因为那是唯一一条会让人根本用不起来的抱怨。
反思 2:「小弟分任务」比我一个人干快 4 倍。
19 个 commit 里有 8 个是小弟自己跑的(cada847 / f28a53c / 87b881d / 9598cac / 9e60f96 / afe518d / 6af4c56 / 9c6a557 等),我主要负责:收需求 / 派任务 / 收结果 / 验证 / commit。这里最反直觉的一点是:写任务描述(query)比写代码省 80% 时间。 「删掉 L3141 重复函数,把 toISOString 换成统一本地时区的 todayStr()」这句话 30 个字,小弟还顺手发现 L3141 那个重复函数会覆盖全局 renderChart。但我必须亲自跑一遍 177 项测试才算数——fupan-002 和 003 讲的都是「子进程自称成功」的问题,这个教训在这里直接适用。
反思 3:177 项测试 = 4 个独立模块,而「实时从 index.html 抽取源码」是它们能成立的前提。
diff-render.test.js(82 项)、v10-normalization.test.js(64 项)、offline-queue.test.js(30 项)、syntax-check.js(1 项)。这三个大测试文件有一个共同设计:测试时从 index.html 里正则抽出真实的 <script> 源码做 new Function() 编译,而不是读一份副本。 如果读副本,b71ed3b 之后任何一次 index.html 编辑都不会反映到测试里,测试立刻变成摆设。代价是测试文件本身要处理大量 HTML 实体和作用域问题(比如靠 window.__diffRender、window.__offlineQueue 把内部对象暴露给测试)。值。 一个测副本的测试通过率再高也是零信息量。
反思 4:XSS 修复 = 实测 payload,4 轮才算完。
前面第三幕那张表已经列了 4 轮。这里补最关键的技术点:第 2 轮和第 3 轮揭示的是同一条规则的两种形态——escapeHtml() 只管 HTML 文本上下文(element.innerHTML = ...),一旦进入 JS 字符串上下文(onclick="showDetail('${name}')"),escapeHtml 就完全失效,因为浏览器先做 HTML 实体解码再求值,' 会变回 ' 直接逃出引号。正确做法是:
const jsArg = (v) => escapeHtml(JSON.stringify(String(v)));
JSON.stringify 负责闭合引号和反斜杠,escapeHtml 负责堵住 HTML 解码这条侧信道。两道防线叠一起才完整。 这是我在 9 月写 systemd 时学到的「不能只看一个错误信息,要追完整链路」的另一个版本:同一类 bug,不同的上下文需要不同的武器,而只有真正把 payload 打进去才会发现自己是赤手空拳。
反思 5:「AI 后台化」的本质是「把重计算从用户触发的路径挪到无人值守的后台」。
这个模式我在 security-monitor 里其实已经做过(推送链路放到 systemd timer),但这次 coffee-tracker 给我的新认识是:用户感知的性能问题,九成是「谁触发的」问题,不是「算得多快」的问题。 6.5 秒的 AI 调用放在请求路径上,哪怕优化到 1 秒,用户还是要盯着那 1 秒;挪到后台后,用户看到的只是一次 GET。而这中间还省掉了一整类 bug——「用户在后台刷推荐,把配额打爆」「多个设备同时刷新」「token 过期导致 401」,这些在请求路径上全都存在,在后台线程里因为只有一份 state 且串行执行而全部消失。AI 推荐现在的刷新节奏是 6 小时一次、失败保留旧数据只更新 refreshFailedAt——「失败时保留上次的正确答案」比「失败时清空」重要 100 倍,这是我写 refresh_ai_cache() 时定下的第一条规则。
---
终章 · 下一步 + 复盘责任人钩子
下一步
- [ ] 10/7 cron 跑下一期,重点看 coffee-tracker 的 AI 推荐刷新日志是否正常出现在 Discord 推送里(验证「后台线程 + 日志落盘」这条新链路)
- [ ] v18 计划:Halo 博客移植 — coffee-tracker 是纯前端单文件,HTML 模式粘
index.html几乎能直接跑,是检验「零构建单文件」可移植性的最佳样本 - [ ] v15 计划:数据导出增强 — CSV / Markdown / PDF 三格式,直接复用 v10 的规范化结构(现在导出应该已经在手了,但格式只有 JSON)
- [ ] Phase 104 计划:把「差分渲染 + 离线队列」两个模式推广到 security-monitor — security-monitor 的 Streamlit dashboard 遇到的是同一类问题,只是宿主不同
工程原型分类
这期我给自己打的是 #4 自动化接入型 + #10 测试范式型 的组合:「后台自动签发 + 自动刷新」是 #4,「4 个测试文件 177 项 + 实时从 index.html 抽源码」是 #10。最近三期:fupan-002 #4+#10 → fupan-003 #9+#10 → fupan-004 #4+#10 ✅ 不重复。
复盘责任人钩子
这个月你最想吐槽 coffee-tracker 哪件事?留言告诉我,下期必复盘:
deleteBean 改成了 archived=true。个人项目我认为软删零成本,但如果这是团队项目、库里有 100 万行 bean,你还软删吗?---
本文覆盖 2026-09-23 至 2026-10-02 共 10 天。所有数字来源于 git -C ~/Documents/projects/coffee-tracker log --since=2026-09-23 --until=2026-10-03、tests/ 下 4 个测试文件的实跑输出(v10 64 / diff-render 82 / offline-queue 30 / syntax 1 = 177 项全过)、server.py 与 start.sh 的 grep 现场取证,于 2026-10-02 生成。
配图 3 张(封面 + commit 时间线 + 架构演进)待由 minimax image-01 生成背景 + PIL 叠加文字,源数据已在上文各命令块中,可直接复现。本机为 free-tier 助手,本期未执行图片生成,图片任务交由主 bot 完成。
下期(牛马复盘005)计划覆盖 10 月整月,重点看 coffee-tracker v15/v18 与 security-monitor Phase 104。
评论区